SpringBoot 启动分析(一)

SpringBoot 启动分析 序列文章基于 spring-boot-starter-parent 1.5.19.RELEASE 。

1. 启动一个 SpringBoot 应用

启动一个 SpringBoot 应用只需要下面几行代码即可:

@SpringBootApplication
public class SpringBootDemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(SpringBootDemoApplication.class, args);
    }
}

查看 SpringApplication.run 方法时会来到:

public static ConfigurableApplicationContext run(Object source, String... args) {
    return run(new Object[] { source }, args);
}

public static ConfigurableApplicationContext run(Object[] sources, String[] args) {
    return new SpringApplication(sources).run(args);
}

可以看到 SpringBoot 的魔法就是那么简单:创建一个 SpringApplication,执行其 run 方法。
就像 “打开冰箱门、把大象塞进冰箱、关上冰箱门” 那么简单、有力。

当然,要了解原理是不能只看高层抽象的。

2. SPI 机制 SpringFactoriesLoader

SpringFactoriesLoader 是 Spring 提供的 SPI 实现机制,从类路径下的 META-INF/spring.factories 文件里加载指定接口的所有实现。以接口的完整类名作为 key,实现类的完整名字作为值,多个实现类用 , 分隔。

下面是 spring-boot-autoconfigure 包下 META-INF/spring.factories 文件里的 一小部分:

# Auto Configure
org.springframework.boot.autoconfigure.EnableAutoConfiguration=\
org.springframework.boot.autoconfigure.admin.SpringApplicationAdminJmxAutoConfiguration,\
org.springframework.boot.autoconfigure.aop.AopAutoConfiguration,\
org.springframework.boot.autoconfigure.amqp.RabbitAutoConfiguration,\
org.springframework.boot.autoconfigure.batch.BatchAutoConfiguration,\
org.springframework.boot.autoconfigure.cache.CacheAutoConfiguration,\
org.springframework.boot.autoconfigure.cassandra.CassandraAutoConfiguration,\
org.springframework.boot.autoconfigure.cloud.CloudAutoConfiguration,\

SpringFactoriesLoader 内部通过 ClassLoader.getResources 方法来加载类路径下的文件。

继续阅读 →

SpringBoot 启动分析(二)–启动主流程

1. initialize 方法

SpringApplication 的构造函数只调用了 initialize 方法:

private void initialize(Object[] sources) {
    if (sources != null && sources.length > 0) {
        // 把应用指定的配置类加入配置扫描的启动来源
        this.sources.addAll(Arrays.asList(sources));
    }

    // 判断应用是否是 web 应用,主要用于决定采用哪种具体的上下文实现
    this.webEnvironment = deduceWebEnvironment();

    // 利用定制的 SPI 实现 SpringFactoriesLoader 加载 ApplicationContextInitializer 的所有实现并设置到 initializers 属性
    setInitializers((Collection) getSpringFactoriesInstances(ApplicationContextInitializer.class));

    // 利用定制的 SPI 实现 SpringFactoriesLoader 加载 ApplicationListener 的所有实现并设置到 listeners 属性
    setListeners((Collection) getSpringFactoriesInstances(ApplicationListener.class));

    // 找出启动类:线程栈上 main 方法所处的类
    this.mainApplicationClass = deduceMainApplicationClass();
}

该方法的逻辑主要如下:

  1. 把启动类加入 sources 属性。
  2. 判断是否是 web 应用并设置到 webEnvironment 属性。
  3. 加载所有的 ApplicationContextInitializer 并设置到 initializers 属性。
  4. 加载所有的 ApplicationListener 并设置到 listeners 属性。
  5. 找出 main 类设置到 mainApplicationClass。

2. run 方法

继续阅读 →

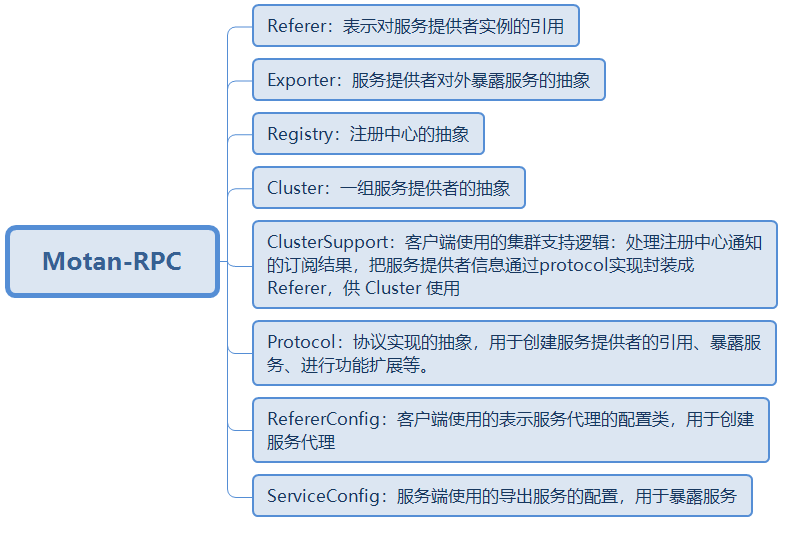
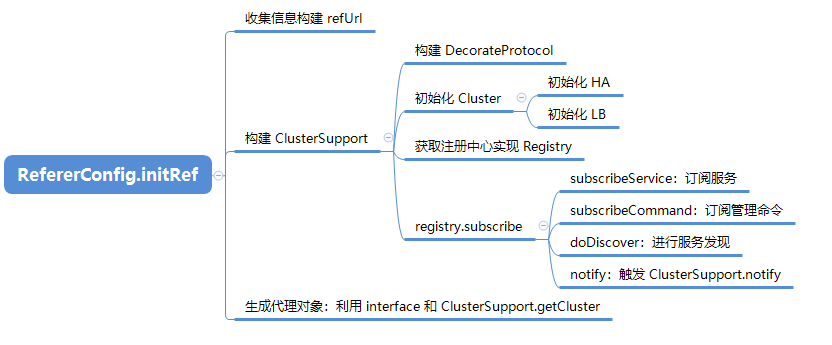
Motan RPC 框架分析

一、框架简介

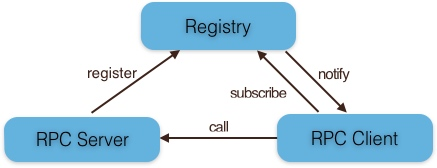
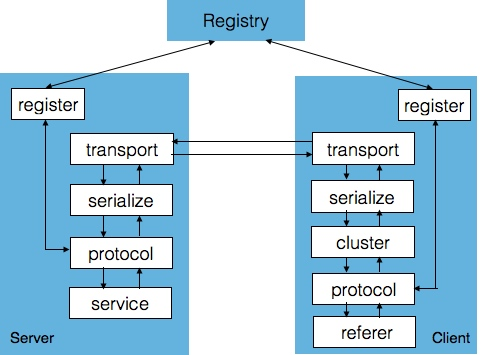
Motan 是新浪微博开源的一套高性能、易于使用的分布式远程服务调用(RPC)框架。

Motan 的核心模块交互关系如下:

二、核心模块介绍

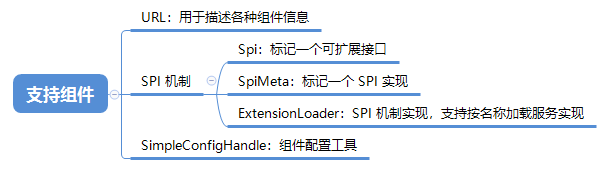
2.0 SPI 机制

SPI 机制支持 JDK 的 ServiceProvider 机制并进行了扩展,接口的实现放在 META-INF/services/ 目录下以接口的完全类名命名的文件里,每个实现的完全类名占一行。

每个实现类可以加上注解 @SpiMeta(name="implName") 来指定实现名称,ExtensionLoader 可以通过接口类型和命名从多个实现中找到指定实现。

继续阅读 →

8皇后问题

一、问题

一个 8×8 的棋盘,希望往里放 8 个棋子,每个棋所在的行、列、对角线上都不能有其他棋子。找出所有满足要求的布局。

二、分析与解

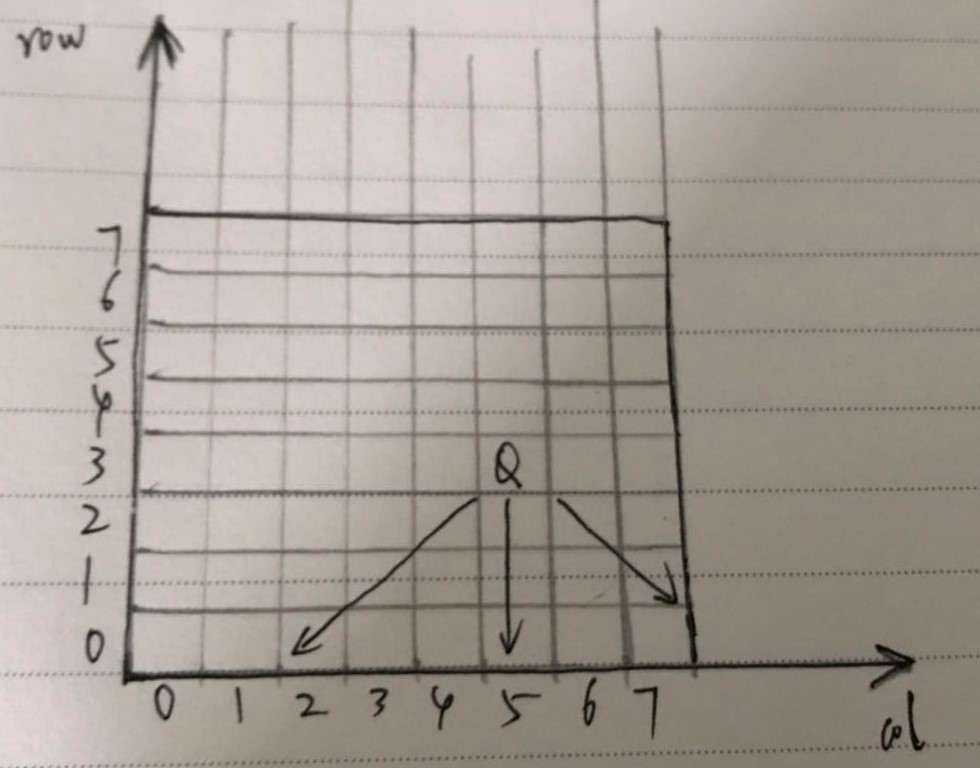
首先画出下面这样一个棋盘:

行、列的下标都是从 0 开始。

逐行摆放棋子,比如当前要摆放第 R 行的棋子时,认为 0 至 R-1 行的棋子是符合要求的,那么对于第 R 行,尝试把棋子摆放到第 C 列,检测是否满足要求,如果满足则继续下一行摆放下一行,不满足则则尝试放至 C+1 列。如果摆放到了第 8 行,则认为得到了一个解。

检测算法:从上图可以看出,只需要检查三种场景,对于位置(row, col):

  1. 左下对角线;该对角线上的点符合 col >= 0 && (row--, col--)。
  2. 垂直列;(row–, col), 行 渐减,列不变。
  3. 右下对角线。该对角线上的点符合 col < 8 && (row--, col++)。

继续阅读 →

SpringBoot druid 踩坑笔记

这是一个同事碰到的案例。

现象

SpringBoot 应用卡死、无反应。

处理过程

1、 导出线程栈,发现 Tomcat 处理线程都阻塞在获取连接上,从栈上看连接池使用的是 druid。

2、 对照 druid 源码,发现线程一直被阻塞是因为没有设置获取连接的超时时间。而从配置来看是有设置的。被阻塞的线程栈如下:

"http-nio-8006-exec-200" #7057 daemon prio=5 os_prio=0 tid=0x00007fc82c0a3800 nid=0x1b99 waiting on condition [0x00007fc7c9a57000]
   java.lang.Thread.State: WAITING (parking)
    at sun.misc.Unsafe.park(Native Method)
    - parking to wait for  <0x00000000c2923bd8> (a java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject)
    at java.util.concurrent.locks.LockSupport.park(LockSupport.java:175)
    at java.util.concurrent.locks.AbstractQueuedSynchronizer$ConditionObject.await(AbstractQueuedSynchronizer.java:2039)
    at com.alibaba.druid.pool.DruidDataSource.takeLast(DruidDataSource.java:1444)
    at com.alibaba.druid.pool.DruidDataSource.getConnectionInternal(DruidDataSource.java:1088)
    at com.alibaba.druid.pool.DruidDataSource.getConnectionDirect(DruidDataSource.java:953)
    at com.alibaba.druid.filter.FilterChainImpl.dataSource_connect(FilterChainImpl.java:4544)
    at com.alibaba.druid.filter.stat.StatFilter.dataSource_getConnection(StatFilter.java:661)
    at com.alibaba.druid.filter.FilterChainImpl.dataSource_connect(FilterChainImpl.java:4540)
    at com.alibaba.druid.pool.DruidDataSource.getConnection(DruidDataSource.java:931)
    at com.alibaba.druid.pool.DruidDataSource.getConnection(DruidDataSource.java:923)
    at com.alibaba.druid.pool.DruidDataSource.getConnection(DruidDataSource.java:100)

3、 通过内存 dump 发现,druid 连接池除 连接串、用户名、密码等几个属性之外的属性都是默认值。
此时连接池里总共有8个连接,都是空闲的,却没有线程能获取到连接,都在阻塞、没有被唤醒。网上查了下,应该是 druid 的bug。

继续阅读 →

《MySQL 实战45讲》–笔记–锁

锁

根据加锁的范围,MySQL 里面的锁大致可以分成全局锁、表级锁和行锁三类。

全局锁

全局锁是对整个数据库实例加锁。MySQL 提供的一个加全局锁的命令: Flush tables with read lock (FTWRL),让整个库处于只读状态。

全局锁的典型使用场景是做全库逻辑备份。

逻辑备份工具 mysqldump 使用参数 -single-transaction 的时候在导数据之前就会启动一个事务,来确保拿到一致性视图。

一致性读的前提是引擎要支持这个隔离级别的事务。

set global readonly=true 也可以让全库进入只读状态。但存在两个风险: readonly 的值可能被用来做其他逻辑,比如判等一个库是主库还是备库;设置 readonly 之后,如果客户端发生异常,则数据库会一直保持 readonly 状态。

在 slave 上,如果用户有超级权限的话,全库只读 readonly=true 是失效的。

FTWRL 执行完后如果客户端异常断开,MySQL 会自动释放这个全局锁,整个库回到可以正常更新的状态。

继续阅读 →

《MySQL 实战45讲》–笔记–order by 实现

用 explain 命令查看执行计划的时候,Extra 列的值含有 “using filesort” 表示需要排序,可能是在内存里排序、也可能是磁盘文件排序。MySQL 给每个线程分配一块内存用于排序,称为 sort_buffer ,可以通过参数 sort_buffer_size 调整这个内存的大小。

如果要排序的数据都能放进 sort_buffer 则直接在内存里排序,否则需要借助磁盘临时文件进行辅助排序。

由于 InnoDB 是索引组织表,聚簇索引就是主键索引,下面的描述就用 rowid 替代主键值。

走索引全字段排序

  1. 初始化 sort_buffer,确定要放入 sort_buffer 的目标字段;
  2. 根据选择的索引查找满足条件的 rowid;
  3. 通过rowid到聚簇索引树获取整行数据,取目标字段放入sort_buffer;
  4. 从选择的索引取下一个记录的rowid;
  5. 重复步骤 3、4直到不满足条件;
  6. 对 sort_buffer 中的数据按照排序列进行排序。
  7. 遍历排序结果,把目标数据返回给客户端。

继续阅读 →

InnoDB Sorted Index Build

Sorted Index Build

InnoDB 在创建或重建索引时采用 批量加载而不是一次插入一个索引记录的方式。这种索引创建方法也称为 Sorted Index Build ,该方式不支持空间索引。

索引创建有三个阶段:

  1. 第一阶段,扫描聚簇索引,生成索引条目并添加到排序缓存(sort buffer)。当排序缓存满了后,条目被排序、写入临时的中间文件。这个过程也称为 run 。

  2. 第二阶段,一个或多个 run 写入临时中间文件,对文件里的所有条目执行合并排序。

  3. 在第三阶段,排序后的条目被插入到 B+tree 上。

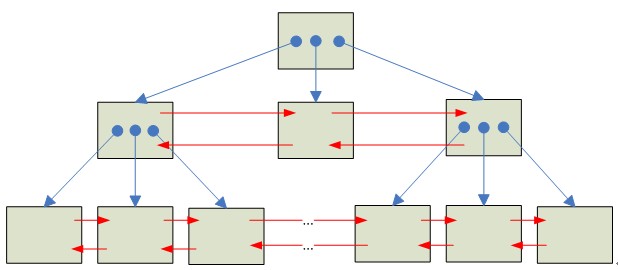
Sorted Index build 采用自底向上方式来构建索引,采用这种方式,在 B+Tree 的每一层,持有对最右叶子页的引用。位于B+Tree需要的深度的最右叶子页被分配,条目按它们排序后的顺序插入。一旦叶子页满了,一个节点指针追加到父页上,同层叶子页被分配用于接下来的插入。这个过程持续至所有条目插入完成,这可能导致插入一直到顶层。

白话解读:最底层的最右叶子页插入索引记录,如果当前最右叶子页满了,生成一个新的最右叶子页作为接下来的插入位置,在新旧最右叶子页之间建立指针链接,然后把指向旧最右叶子页的指针追加到上一层的最右叶子页,触发上一层的最右叶子页插入,逻辑跟前面是一样的,这是个递归的过程,直至根页。这是一个自底向上、递归构建的过程。

最终生成的索引结构如下图(图片来自MySQL内核解析:Innodb页面存储结构-1):
InnoDB索引结构

为后续插入保留空间

可以使用 innodb_fill_factor 配置选项来指定在 B+Tree 页空间保留的空闲百分比,用于后续在这些位置插入索引条目。

这个设置应用于索引树的叶子和非叶子页。不适用于外部页如用于 TEXT/CLOB 条目的。

这个配置是一个提示而非强制约束。